Column
AI 에이전트는 많을수록 똑똑할까? Agent Scaling 논문 흐름 읽기
AI 에이전트 수를 늘리면 성능도 좋아질까요? 샘플링과 투표, 에이전트 간 협업, 추론 비용을 기준으로 Agent Scaling 연구의 흐름과 한계를 살펴봅니다.
안녕하세요~!
AI 한 명보다 열 명이 같이 일하면 더 잘하지 않을까요? 처음 멀티에이전트를 접하면 자연스럽게 드는 생각입니다. 한 명은 자료를 찾고, 한 명은 계산하고, 한 명은 틀린 부분을 지적하면 사람처럼 팀을 만들 수 있을 것 같거든요.
그런데 여기서 조금 이상한 질문이 생깁니다. 같은 모델 열 개에게 같은 자료를 주면 정말 서로 다른 의견을 얻는 걸까요? 열 개가 모두 같은 부분을 잘못 이해하면 투표는 오히려 틀린 답에 확신을 더해줄 수도 있습니다.
오늘은 이 질문을 따라 Agent Scaling 관련 문헌을 정리해보겠습니다. 앞선 글이 에이전트 시스템을 어떻게 구성할지에 대한 설명이었다면, 이번에는 그렇게 구성했을 때 실제로 더 잘한다는 근거가 무엇인지를 보는 글입니다.
범위는 LLM 기반 에이전트입니다. 로봇 군집 제어나 전통적인 multi-agent reinforcement learning 전체를 다루는 리뷰는 아닙니다. 2026년 10월 23일까지 확인한 자료 중 논점을 보여주는 연구를 골랐고, 체계적 문헌고찰이나 모든 논문의 순위표를 만든 것은 아닙니다. 최근 arXiv 논문은 동료심사 완료 여부를 확인하지 못한 경우 프리프린트로 취급했습니다.
1. Scaling이라는 말에 서로 다른 실험이 섞여 있습니다
일반적으로 모델 스케일링이라고 하면 파라미터, 학습 데이터, 학습 계산량을 늘리는 이야기를 떠올립니다. 에이전트 스케일링에서는 모델을 그대로 두고도 바꿀 수 있는 것이 많습니다.
한 에이전트가 더 오래 생각하게 할 수도 있고, 여러 답을 따로 생성한 뒤 하나를 고를 수도 있습니다. 에이전트 사이의 대화 횟수를 늘리거나, 각자 다른 도구와 자료를 주는 방법도 있죠. 에이전트 숫자는 이 중 한 축입니다.
이 차이를 무시하면 비교가 이상해집니다. 한 번 답한 모델과 열 명이 여러 차례 토론한 시스템을 비교해 더 높은 점수를 얻었다면, 그것은 유용한 결과일 수 있어요. 하지만 협업 구조 덕분인지, 계산을 훨씬 많이 했기 때문인지는 아직 분리되지 않았습니다.
그래서 저는 논문 제목에 “multi-agent”가 있어도 실험에서 실제로 늘린 자원이 무엇인지부터 보려고 합니다. 호출 횟수인지, 전체 토큰인지, 실제 비용인지, 사용자가 기다린 시간인지요. 같은 숫자처럼 보여도 서로 대체할 수 없는 자원입니다.
2. 출발점은 의외로 단순합니다: 여러 번 풀고 골라보기
Self-Consistency는 하나의 추론 경로만 사용하는 대신 여러 경로를 생성하고, 답을 모아 선택하는 방식을 제안했습니다. 여러 AI가 회의를 하는 시스템은 아니지만, 추론 시점에 계산을 더 쓰는 비교 기준으로 중요합니다. 이 논문은 ICLR 2023에 발표됐습니다. Self-Consistency 원문
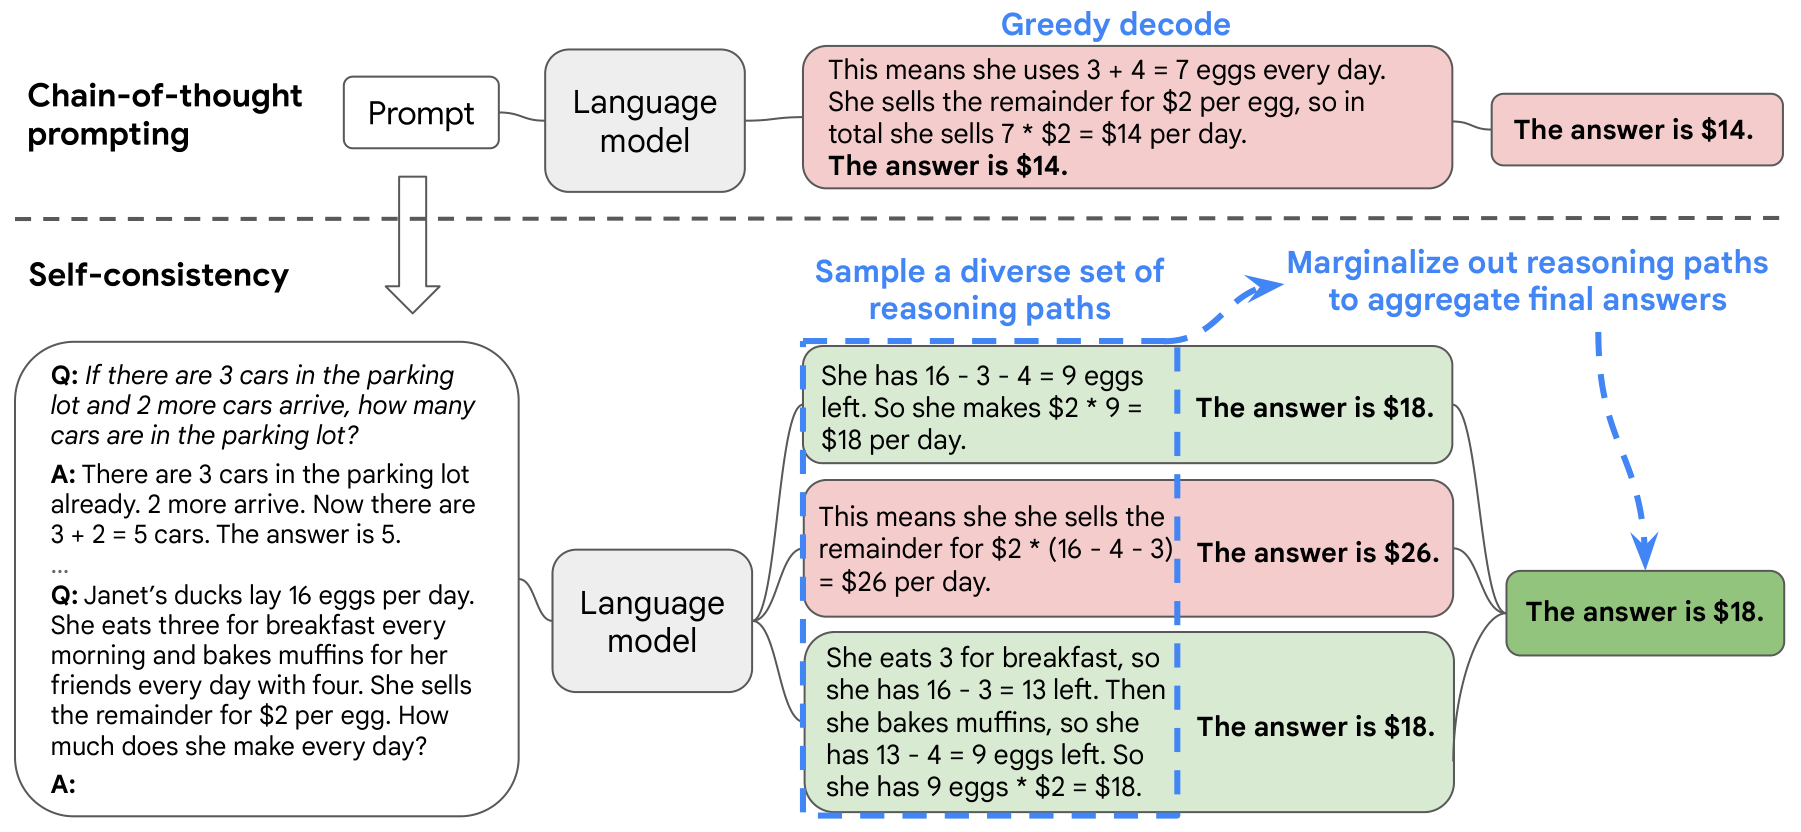
출처: Wang et al., Self-Consistency, Figure 1, 원문 PDF 2쪽. CC BY 4.0. 그림 영역 발췌·크기 조정·WebP 변환 외 내용 변경 없음.
위쪽은 답을 한 번 이어가는 경우이고, 아래쪽은 경로를 여러 개 만든 뒤 최종 답을 모으는 경우입니다. 아래의 세 경로 중 하나는 여전히 틀려요. 모든 생각을 정답으로 만드는 것이 아니라, 여러 후보에서 답을 고르는 방식이라는 점이 핵심입니다.
2024년의 More Agents Is All You Need는 이런 질문을 에이전트 수와 연결합니다. Agent Forest라는 sampling-and-voting 방식으로 여러 모델 인스턴스의 답을 모으고, 수를 늘렸을 때의 성능 변화를 살펴봅니다. arXiv 기록에는 TMLR 출판이 명시돼 있습니다. More Agents Is All You Need
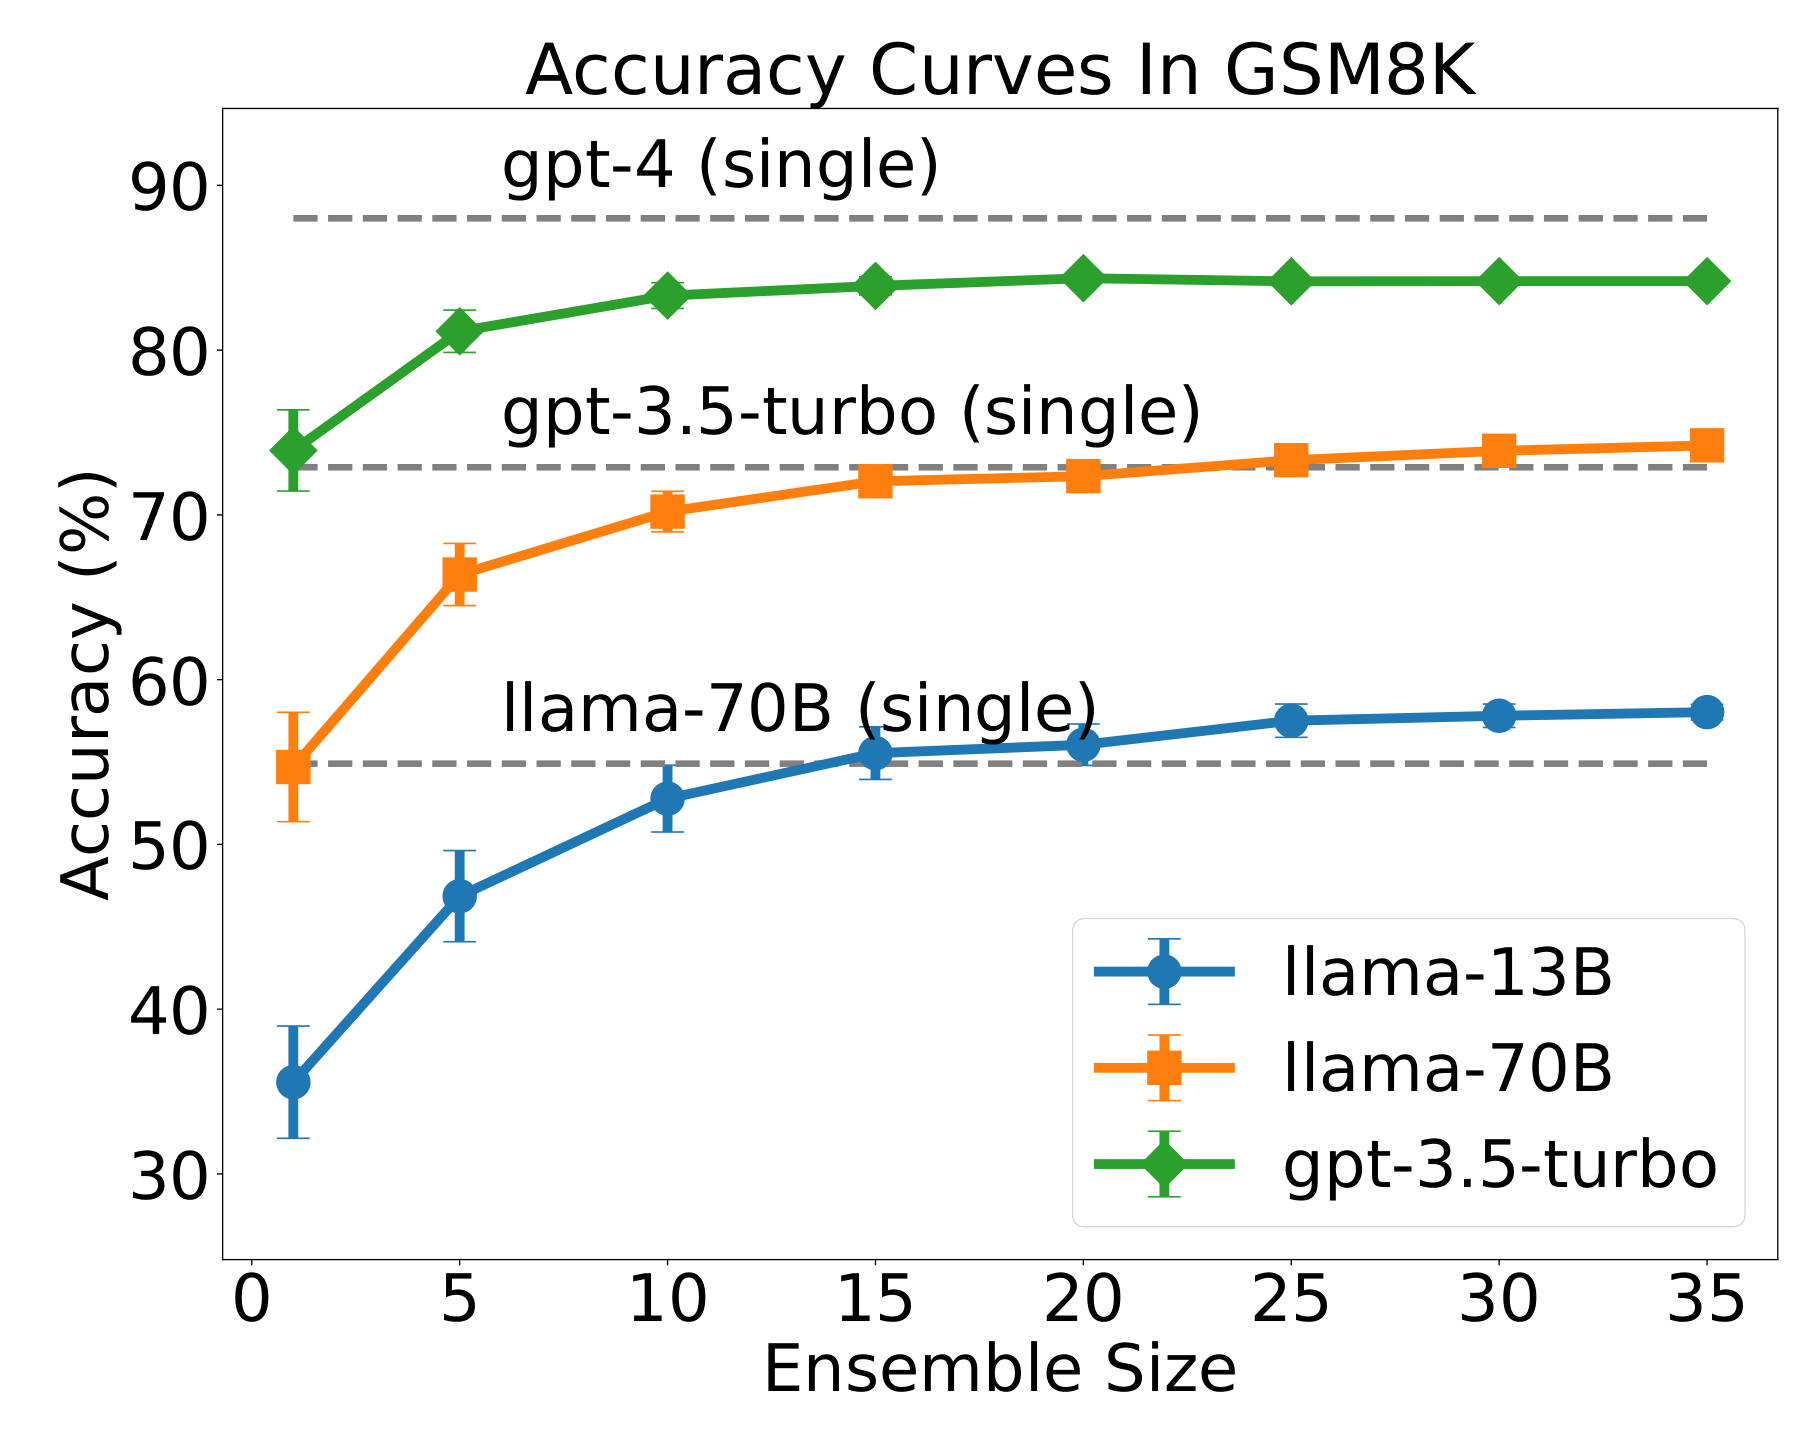
출처: Li et al., More Agents Is All You Need, TMLR 2024, Figure 1, 출판본 사본 PDF 2쪽 · 공식 출판 기록. TMLR의 CC BY 4.0 정책에 따라 그림 영역을 발췌했습니다. 데이터·축·범례는 그대로입니다.
가로축은 앙상블 크기, 세로축은 GSM8K 정확도입니다. 초반에 오르던 곡선이 뒤로 갈수록 완만해지는 것도 같이 봐야 해요. 이 그래프는 당시 모델과 수학 벤치마크에서 얻은 결과이지, 최신 에이전트를 계속 늘리면 어떤 작업이든 좋아진다는 보장은 아닙니다.
여기서 재미있는 점은 출발점이 꼭 복잡한 역할극이 아니었다는 것입니다. 독립적인 후보를 여러 개 만드는 것만으로도 얻는 이익이 있다면, 새 협업 방법은 그 기준보다 얼마나 나은지를 보여줘야겠죠.
다만 답을 골라낼 수 있다는 조건이 중요합니다. 숫자 문제처럼 답을 비교하기 쉬운 경우와, 새로운 사업 전략이나 논문 아이디어처럼 정답이 뚜렷하지 않은 경우는 다릅니다. 후보가 늘어나는 것과 좋은 후보를 알아보는 것은 별개예요.
간단한 계산으로 보는 투표의 조건
실제 LLM 실험이 아닌 설명용 예시를 하나 들어보겠습니다. 각자가 정답을 낼 확률이 60%인 이진 선택 문제에서, 다섯 명의 오류가 완전히 독립적이라면 다수결이 맞을 확률은 약 68.3%입니다. 다섯 명 중 세 명 이상이 맞을 확률을 더한 값이에요.
그런데 모두가 항상 똑같은 답을 낸다면 어떨까요? 다섯 명으로 늘려도 정답률은 60% 그대로입니다. 같은 오류를 다섯 번 확인할 뿐이죠.
현실의 LLM은 이 두 극단 사이 어딘가에 있습니다. 학습 데이터와 모델, 프롬프트, 검색 결과를 공유할수록 실수도 겹칠 수 있습니다. 이 예시는 실제 모델의 정답률 예측식이 아니라, 인원수만 알아서는 투표의 이득을 알 수 없다는 것을 보여주기 위한 계산입니다.
3. 2023~2024년: 혼자 푸는 대신 서로의 답을 보게 하면?
Du 등의 Multiagent Debate 연구는 여러 모델 인스턴스가 각자 답과 이유를 제시하고, 여러 라운드에 걸쳐 서로의 내용을 검토하도록 합니다. 논문은 수학·전략적 추론과 사실성 관련 과제에서 개선을 보고합니다. Multiagent Debate, 2023
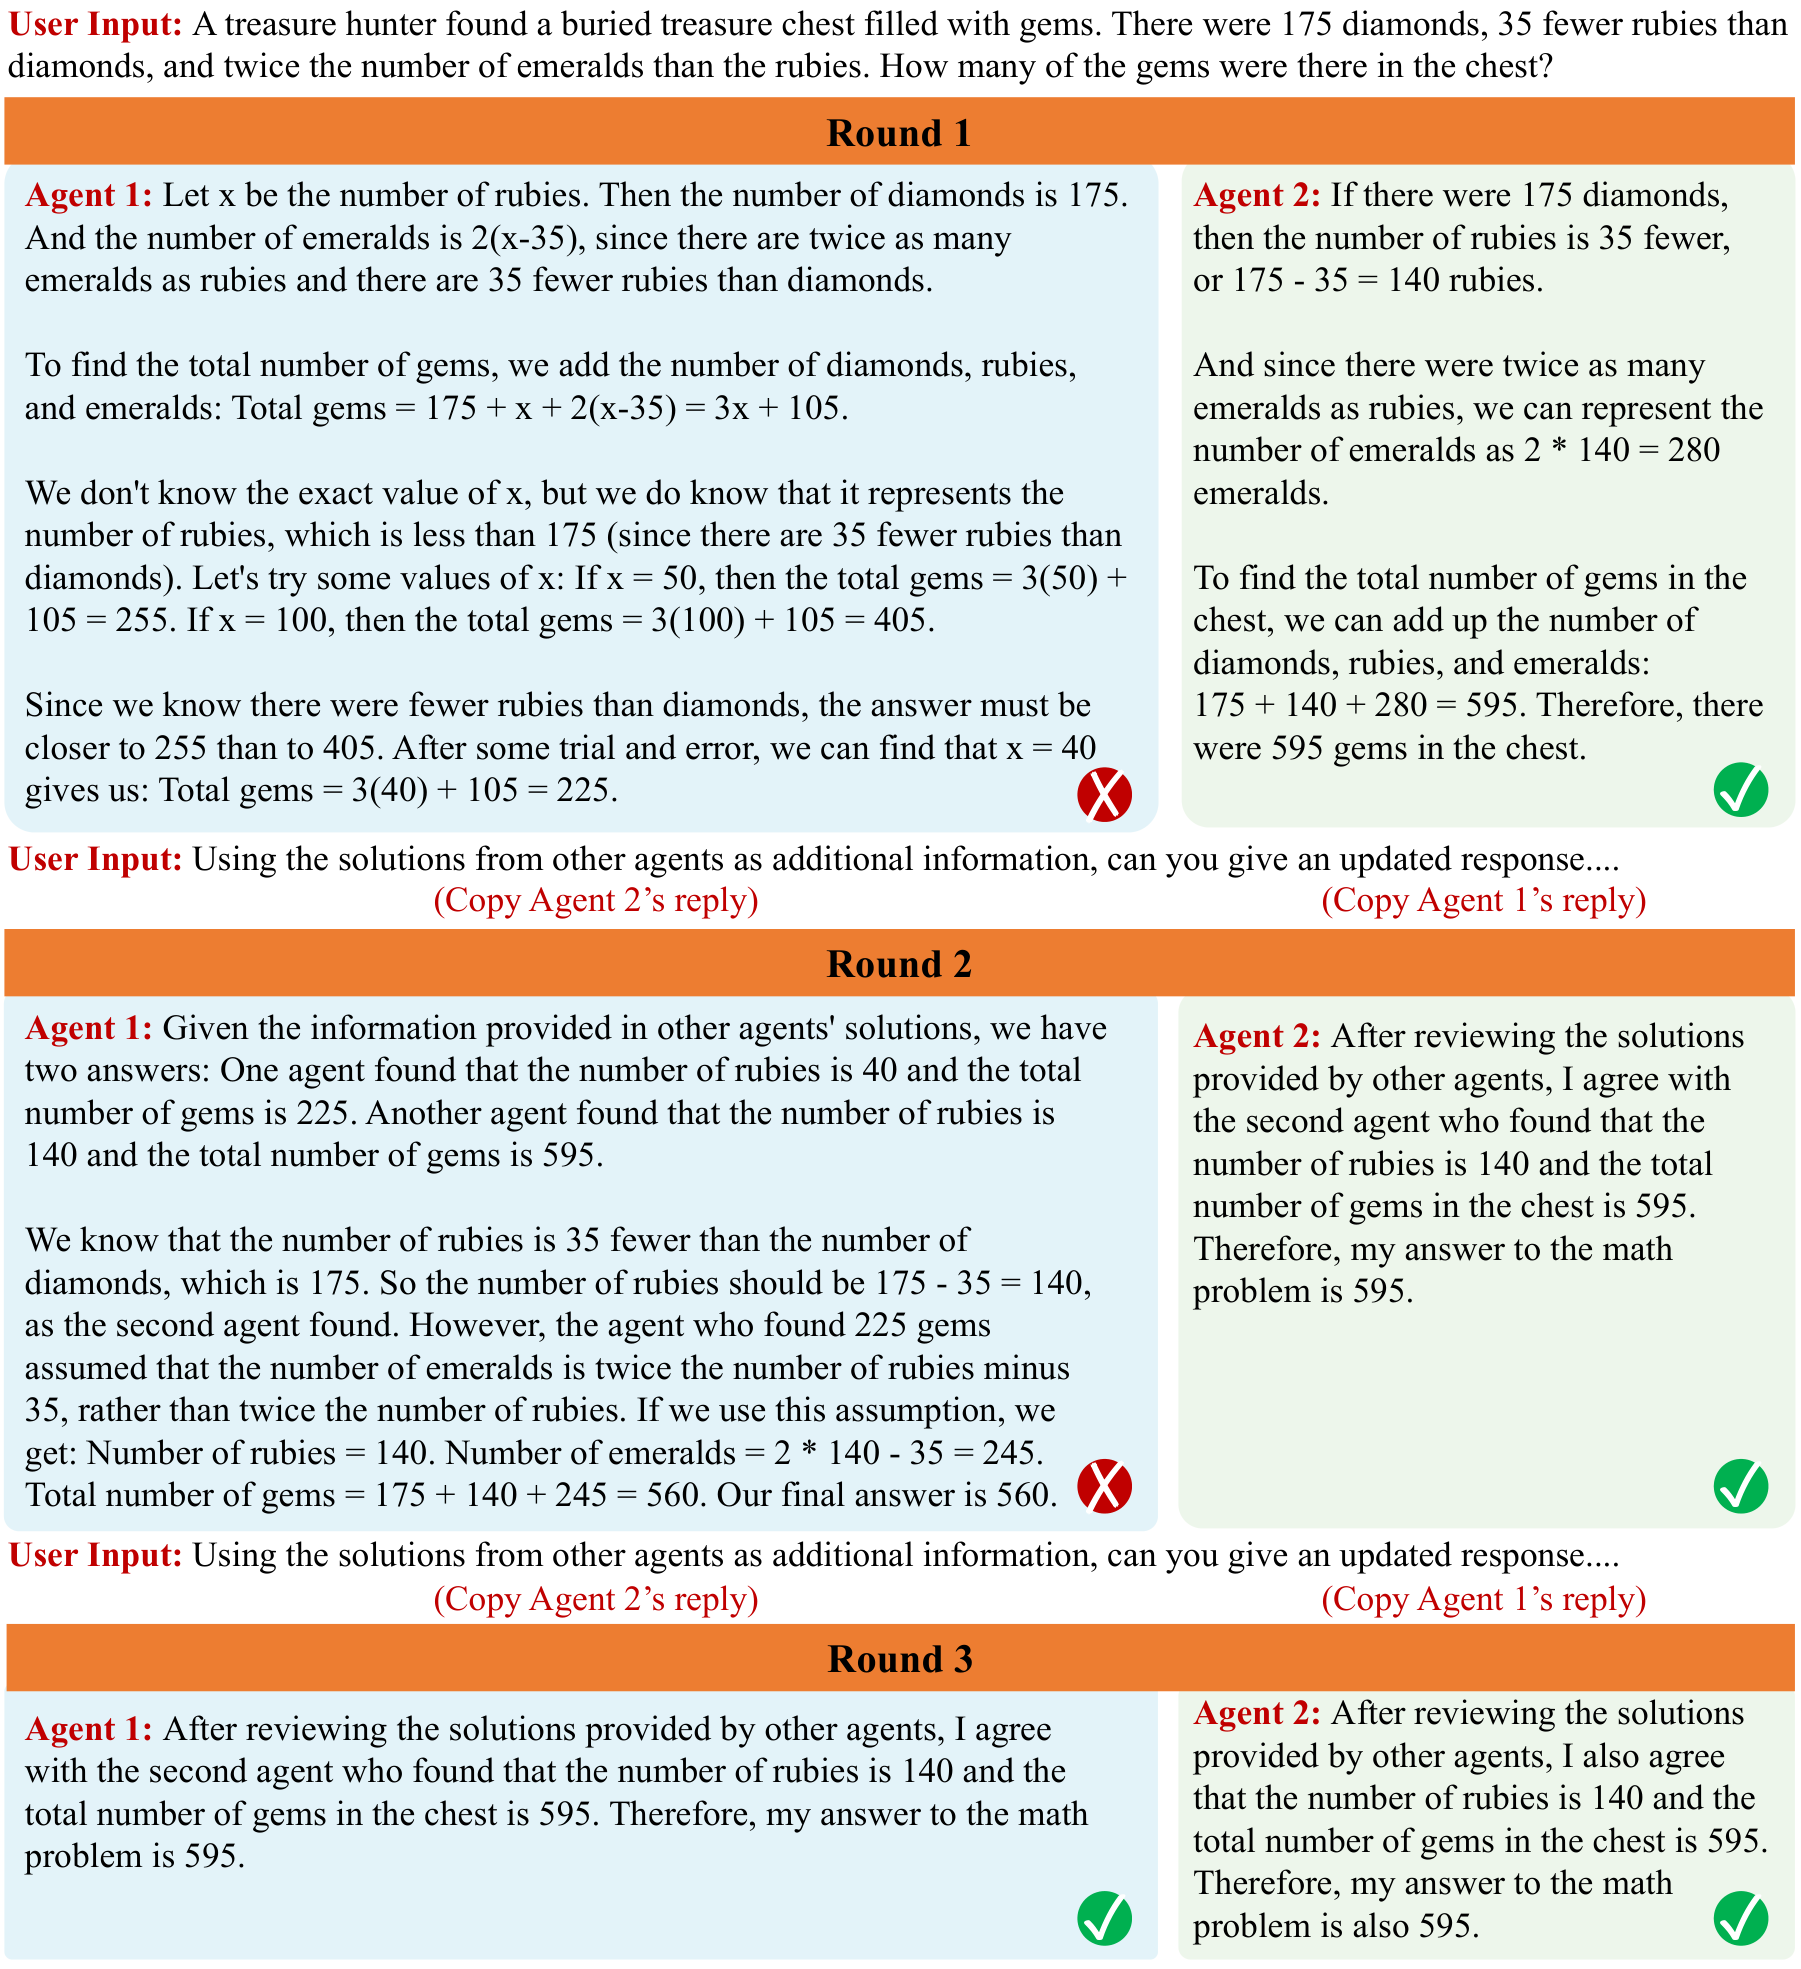
출처: Du et al., Improving Factuality and Reasoning in Language Models through Multiagent Debate, Figure 2, 원문 PDF 3쪽. CC BY 4.0. 원문 그림 영역만 발췌했습니다.
주황색 Round 구분을 따라 내려가면 됩니다. 첫 번째 에이전트는 상대의 답을 보고도 두 번째 라운드까지 계산을 틀리고, 세 번째에야 맞는 답으로 이동합니다. “서로 읽으면 즉시 정답”이 아니라는 점까지 보여주는 예시예요. 반대로 잘못된 의견이 퍼지는 경우도 가능한지는 별도 실험으로 확인해야겠죠.
여기서 투표와 다른 부분은 다른 사람의 답을 보고 자기 답을 바꿀 수 있다는 점입니다. 맞는 근거가 전달되면 도움이 되겠죠. 반대로 틀렸지만 그럴듯한 설명에 모두가 끌려갈 가능성도 생각해야 합니다. 토론이 끝났다는 사실이 정답의 증명은 아닙니다.
Mixture-of-Agents는 또 다른 방식입니다. 여러 모델의 응답을 다음 층의 입력으로 넣어 더 나은 응답을 구성합니다. 2024년 논문은 AlpacaEval 2.0, MT-Bench, FLASK 같은 응답 평가를 사용했습니다. 여기서의 MoA는 하나의 신경망 내부에서 전문가 모듈을 라우팅하는 Mixture-of-Experts와 구분해야 합니다. Mixture-of-Agents 원문
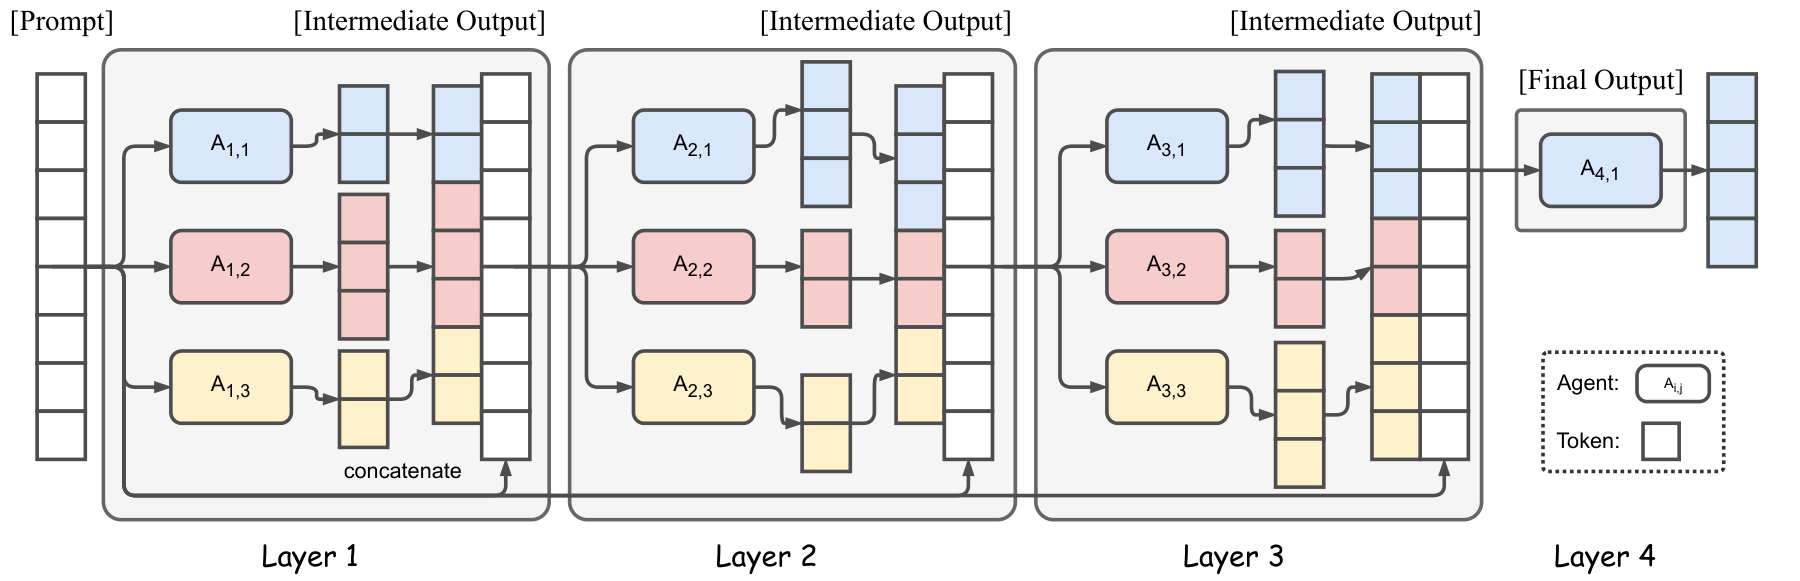
출처: Wang et al., Mixture-of-Agents Enhances Large Language Model Capabilities, Figure 2, 원문 PDF 2쪽. CC BY 4.0. 구조도 영역만 발췌·크기 조정했습니다.
상자 사이를 오가는 것은 신경망 내부의 숫자 벡터가 아니라 앞선 모델들이 만든 응답입니다. 여러 응답을 이어 붙여 다음 층에 넘기고, 마지막에는 하나의 답을 내놓습니다. 그림의 층 수와 에이전트 수는 구조를 보여주는 예시이며, 이 숫자가 모든 작업의 최적값이라는 뜻은 아닙니다.
두 연구를 읽으며 중요한 차이를 하나 기억하면 좋겠습니다. 여러 답을 합쳐 더 좋은 문장을 만드는 능력과, 실제 환경에서 작업을 끝내는 능력은 동일하지 않습니다. 답변 선호도 평가에서 좋은 결과를 얻었다고 로그인 오류를 해결하거나 장시간 코드를 수정하는 성능까지 증명한 것은 아니니까요.
저는 이 시기의 연구를 “다 같이 생각하면 되는가?”를 탐색한 단계로 읽었습니다. 이후에는 한 단계 더 현실적인 질문이 붙습니다. 그 대화에 돈이 얼마나 드는지, 중간에 왜 실패하는지요.
4. 통신을 늘렸더니 생각할 예산이 줄었습니다
AgentPrune 논문은 에이전트 사이에 오가는 메시지 중 불필요한 부분을 줄이는 문제를 다룹니다. 공간과 시간에 걸친 메시지 전달 그래프에서 연결을 가지치기하는 접근입니다. 2024년 원고에서는 기존 프레임워크에 적용했을 때 실험 설정에 따라 28.1~72.8%의 토큰 감소를 보고합니다. 이 수치는 제 시스템에서 얻은 절감률도, 모든 서비스에 보장되는 수치도 아닙니다. AgentPrune 원문
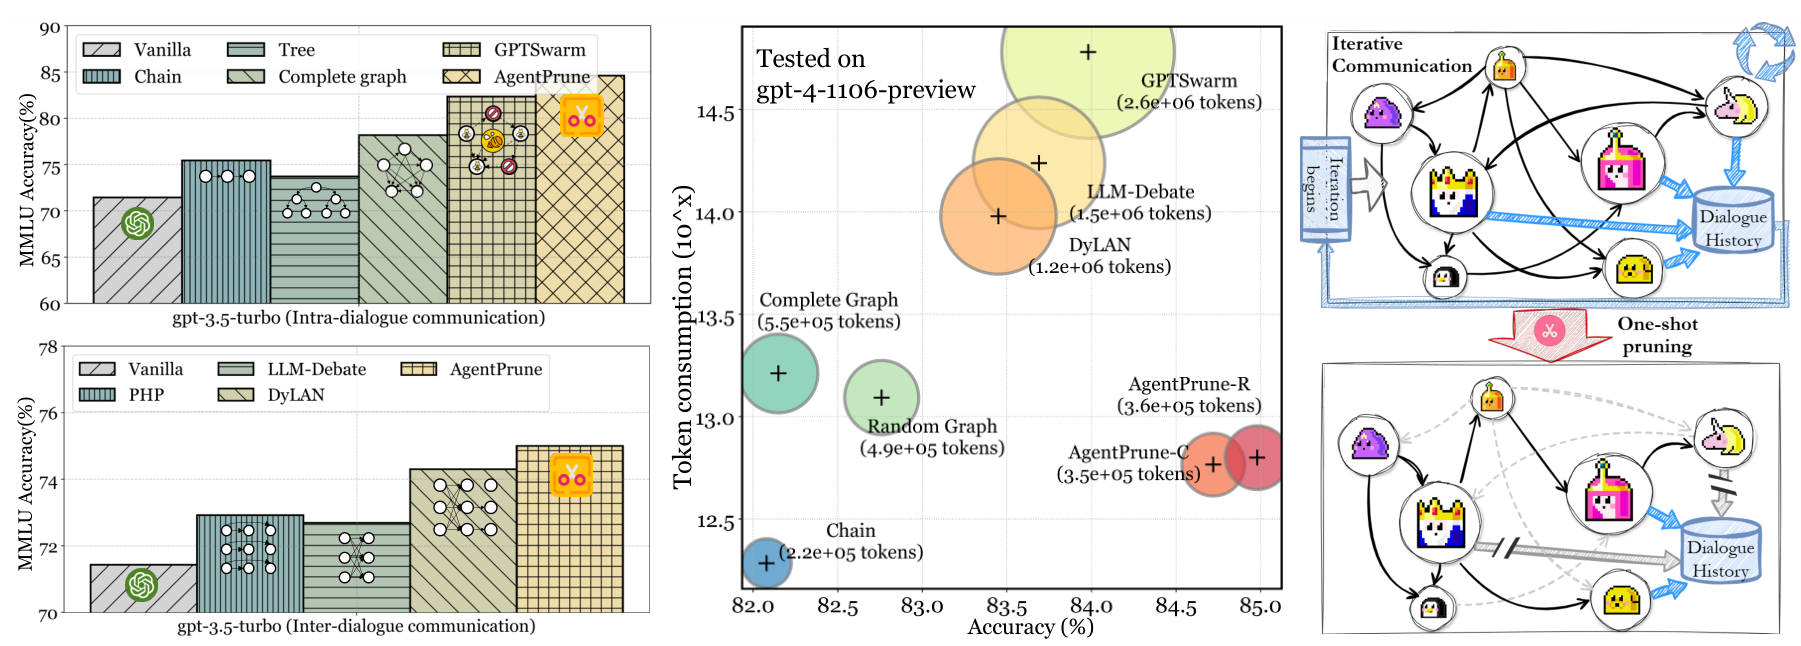
출처: Zhang et al., Cut the Crap, ICLR 2025 출판본 Figure 2, 원문 PDF 2쪽. CC BY 4.0 · 저자 소속기관의 라이선스 안내. 그림 영역만 발췌했으며 위 본문에서 인용한 2024년 프리프린트와 구분해 표시합니다.
가운데 그래프는 오른쪽으로 갈수록 정확도가 높고, 위로 갈수록 프롬프트 토큰을 더 씁니다. 그러니 위쪽의 큰 원이 무조건 좋은 결과는 아니에요. 비슷한 정확도에서 아래로 내려갈 수 있는지, 오른쪽 그림처럼 어떤 통신을 없앴는지 함께 보는 것이 이 논문의 질문에 가깝습니다.
이 연구의 제목이 Cut the Crap인데, 이름은 조금 과격하지만 질문은 실용적입니다. 에이전트가 서로 말을 많이 할수록 일이 잘되는 걸까요? 자료를 중복해서 전달하거나 이미 나온 결론을 계속 설명하면, 대화 자체가 비용이 됩니다.
예를 들어 열 명이 모든 사람에게 한 번씩 메시지를 보낸다고 가정하면, 자기 자신을 제외한 방향성 있는 연결은 10×9=90개입니다. 백 명이면 9,900개가 됩니다. 이것은 모든 시스템의 실제 비용 공식이 아니라 완전 연결 구조의 가능한 전달 관계 수예요. 실제 비용은 메시지 길이와 전달 빈도, 구현에 따라 달라집니다.
그래도 왜 팀 규모가 커질수록 통신 설계가 중요해지는지는 보입니다. 모든 사람이 모든 대화를 읽게 하면 각자의 입력도 커집니다. 반대로 전달을 너무 줄이면 필요한 정보가 누락됩니다. 관리자를 두거나 필요한 자료만 검색해서 가져오게 하는 설계가 나오는 이유입니다.
그래서 통신량을 줄인 결과를 볼 때는 절감률만 볼 것이 아니라, 어떤 정보가 사라졌고 품질이 유지됐는지도 같이 봐야 합니다. 틀린 답을 더 싸게 내는 것은 우리가 원하는 개선이 아니니까요.
5. 실패를 들여다보면 모델 탓만 하기가 어려워집니다
Why Do Multi-Agent LLM Systems Fail?의 v3는 7개 프레임워크에서 수집한 1,600개 이상의 주석된 실행 기록을 설명합니다. 연구진은 150개 기록의 심층 분석을 바탕으로 14개 실패 유형을 만들고, 이를 시스템 설계, 에이전트 간 정렬, 과제 검증이라는 범주로 묶었습니다. MAST 연구, 2025년 v3
분류 전체는 원문 Figure 1에서 볼 수 있습니다. 실행 단계와 실패 유형을 나란히 놓은 그림이라, 내 시스템에서 문제가 생긴 위치를 짚어보기 좋습니다. 이 판본은 비상업용 조건이 있어 여기에는 복제하지 않고 원문 링크를 남깁니다.
이 연구가 에이전트 수를 늘리는 모든 경우의 성능 곡선을 제시하는 것은 아닙니다. 오히려 곡선 뒤에서 무슨 일이 일어났는지 볼 수 있는 분류 틀로 읽는 편이 좋겠습니다.
가령 답이 틀렸을 때 마지막 모델만 바꾸는 대신, 작업 지시가 모호했는지, 중간 결과가 제대로 전달됐는지, 완료를 너무 일찍 선언했는지를 나눠볼 수 있어요. 같은 최종 실패라도 수정해야 할 위치는 다릅니다.
여기서 앞선 하네스 글과 연결됩니다. 더 좋은 모델을 붙이는 것과, 모델이 일할 수 있는 환경을 고치는 것은 별개의 개입입니다. 둘을 동시에 바꿔 성능이 올랐다면 어느 쪽이 얼마나 기여했는지 알기 어렵습니다. 연구에서도 운영에서도 변경 사항을 나눠 기록할 이유가 있습니다.
6. 2026년에는 “어떤 작업인가”가 더 중요해집니다
Towards a Science of Scaling Agent Systems는 구조와 과제의 조합을 비교한 연구입니다. 여기서는 2026년 4월 8일 v3를 기준으로 읽었습니다. 초기 Google Research 소개 글의 180개 구성·4개 벤치마크와 달리, v3는 260개 구성·6개 벤치마크를 보고합니다. 숫자를 섞지 않는 것이 중요합니다.
v3에서 금융 분석 과제의 중앙집중형 구조는 단일 에이전트 대비 평균 점수가 0.349에서 0.631로 증가했습니다. 약 80.8%의 상대 개선이지, 정확도가 80.8%포인트 상승한 것은 아닙니다. 반대로 순차 계획 과제인 PlanCraft의 독립형 구성은 0.568에서 0.170으로 낮아졌습니다. 원문 v3, 4.2절
여기는 원문 Figure 2의 여섯 패널을 같이 보면 차이가 더 선명합니다. Finance Agent와 PlanCraft를 번갈아 보세요. 같은 협업 구조라도 과제에 따라 결과의 방향이 달라집니다. 원문 그림의 재배포 허용을 확인하지 못해 캡처 대신 해당 그림으로 직접 연결했습니다.
이 결과를 “금융은 무조건 멀티, 코딩은 무조건 싱글”로 외우면 또 곤란합니다. 해당 모델과 도구, 예산, 과제에서 관찰한 결과입니다. 같은 금융 업무라도 자료 조사와 실제 주문 실행은 의존 구조가 다르겠죠.
논문은 주로 작은 팀을 다루며 에이전트 수 탐색도 최대 9명 수준입니다. 따라서 이 실험으로 수백·수천 에이전트의 가능성까지 판정할 수는 없습니다. 또한 보고된 87%는 보류한 구성에서 최적 구조를 고른 비율이지 에이전트의 과제 성공률이 아닙니다. 원문 v3, 4.5~5절
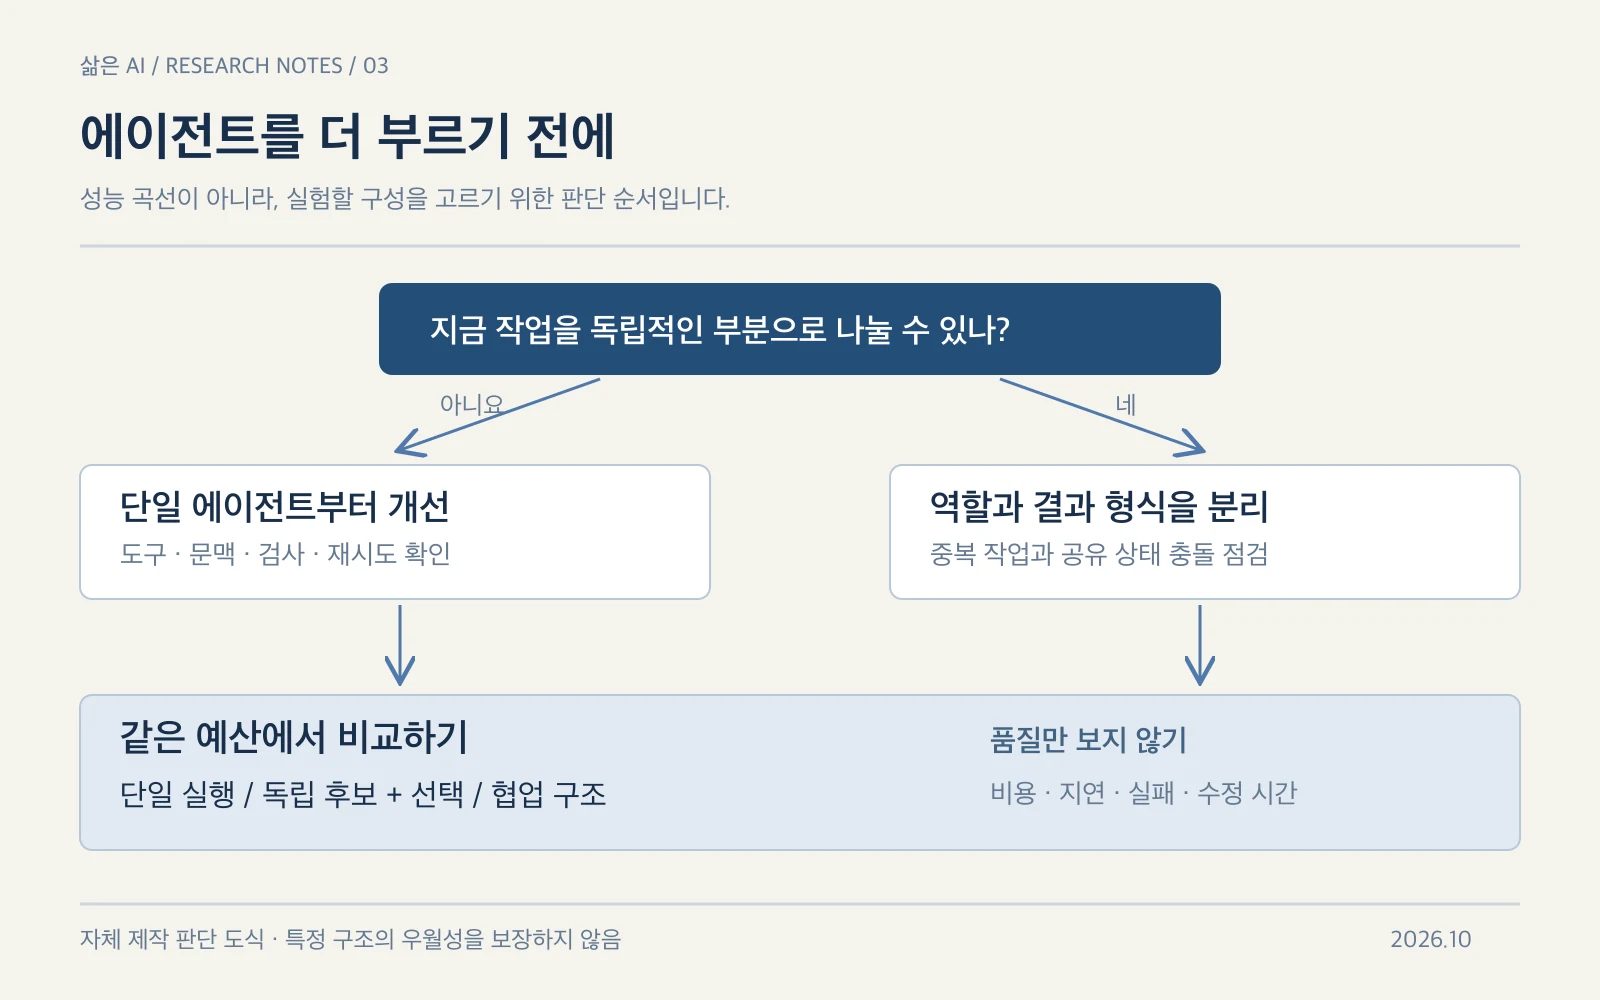
제가 이 논문에서 가져오고 싶은 질문은 간단합니다. 나누면 쉬워지는 일인가, 나누는 순간 계속 상태를 맞춰야 하는 일인가? 숫자 하나보다 이 구분이 실제 설계에 더 도움이 됩니다.
여러 회사의 공시를 따로 조사하는 일은 분리하기 쉽습니다. 반면 같은 데이터베이스의 상태를 연달아 바꾸는 일은 앞선 행동의 결과에 의존합니다. 이런 일을 억지로 여러 에이전트에 쪼개면 “현재 상태가 무엇인가”를 전달하는 데 시간을 쓸 수 있습니다. 이는 논문의 과제들을 그대로 재현한 예시가 아니라, 작업 의존성을 이해하기 위한 예입니다.
7. 같은 AI 열여섯 명보다 다른 AI 두 명이 나을까?
Understanding Agent Scaling in LLM-Based Multi-Agent Systems via Diversity는 이름 그대로 다양성을 중심에 둡니다. 2026년 2월 프리프린트는 주 실험에서 7B~8B급 공개 가중치 모델과 7개 추론·지식 벤치마크를 사용하고, 모델·역할 등의 구성을 달리하며 투표와 토론을 비교합니다. 일부 설정에서 다양성을 가진 두 에이전트가 동질적인 열여섯 에이전트에 필적하거나 앞서는 결과를 보고합니다. 다양성 연구 원문
그림은 모델 다양성을 비교한 Figure 1과 동질적 에이전트 수를 늘린 Figure 2를 나란히 보시면 됩니다. 하나는 구성을 바꾼 비교이고, 다른 하나는 수를 늘린 비교라는 차이를 놓치지 않는 게 좋습니다. 이 원고 역시 재배포 허용을 확인하지 못해 그림은 원문에서 보도록 연결했습니다.
논문이 사용하는 유효 채널 수 K*는 출력 임베딩의 다양성을 측정하는 대리 지표입니다. 정답을 직접 측정하는 지표는 아니며, 저자들도 의미적으로 다른 출력과 과제에 유용한 정보의 차이를 한계로 명시합니다. 큰 모델의 복잡한 장기 도구 작업으로 곧바로 일반화할 수 없습니다. 원문의 한계 설명
“다양성이 좋다”는 말을 듣고 temperature만 올리는 것도 충분하지 않습니다. 틀린 답이 제각각 나오는 상황은 다양하지만 유용하지 않을 수 있죠. 역할 이름을 의사, 교수, 투자자로 바꾸는 것과 실제로 다른 자료와 도구를 갖게 하는 것도 다른 변화입니다.
제 해석으로는 서로 다른 에이전트가 무엇을 새로 가져왔는가를 보는 것이 중요합니다. 한 명은 원문 공시를 읽고, 다른 한 명은 그 공시의 숫자를 직접 계산한다면 판단 경로가 다릅니다. 둘 다 같은 검색 결과의 첫 문단을 요약했다면 모델 이름이 달라도 독립성이 크지 않을 수 있습니다.
다양성의 효과를 보려면 결국 결과뿐 아니라 오류의 겹침도 봐야 합니다. 혼자 맞힌 문제 수가 비슷한 두 모델이라도 같은 문제를 틀리는지, 서로 다른 문제를 틀리는지에 따라 조합의 의미가 달라집니다. 그리고 그 차이를 최종 답에 반영할 검증기가 필요합니다.
8. 최근 흐름: 처음부터 거대한 조직도를 그려야 할까?
2026년 9월의 Rethinking Multi-Agent Collaboration: When More Is Less는 작업 의존성을 그래프로 보고, 필요에 따라 에이전트와 연결을 늘리는 SAIGE를 제안합니다. 긴 작업 중에서도 의존성이 성긴 경우와 긴밀하게 연결된 순차 작업을 구분합니다. 에이전트 풀이나 재귀 깊이를 키우는 것이 일관되게 성능을 개선하지 않았다는 분석도 포함합니다. 이 글에서는 9월 18일 v2 프리프린트로 다룹니다. SAIGE 원문
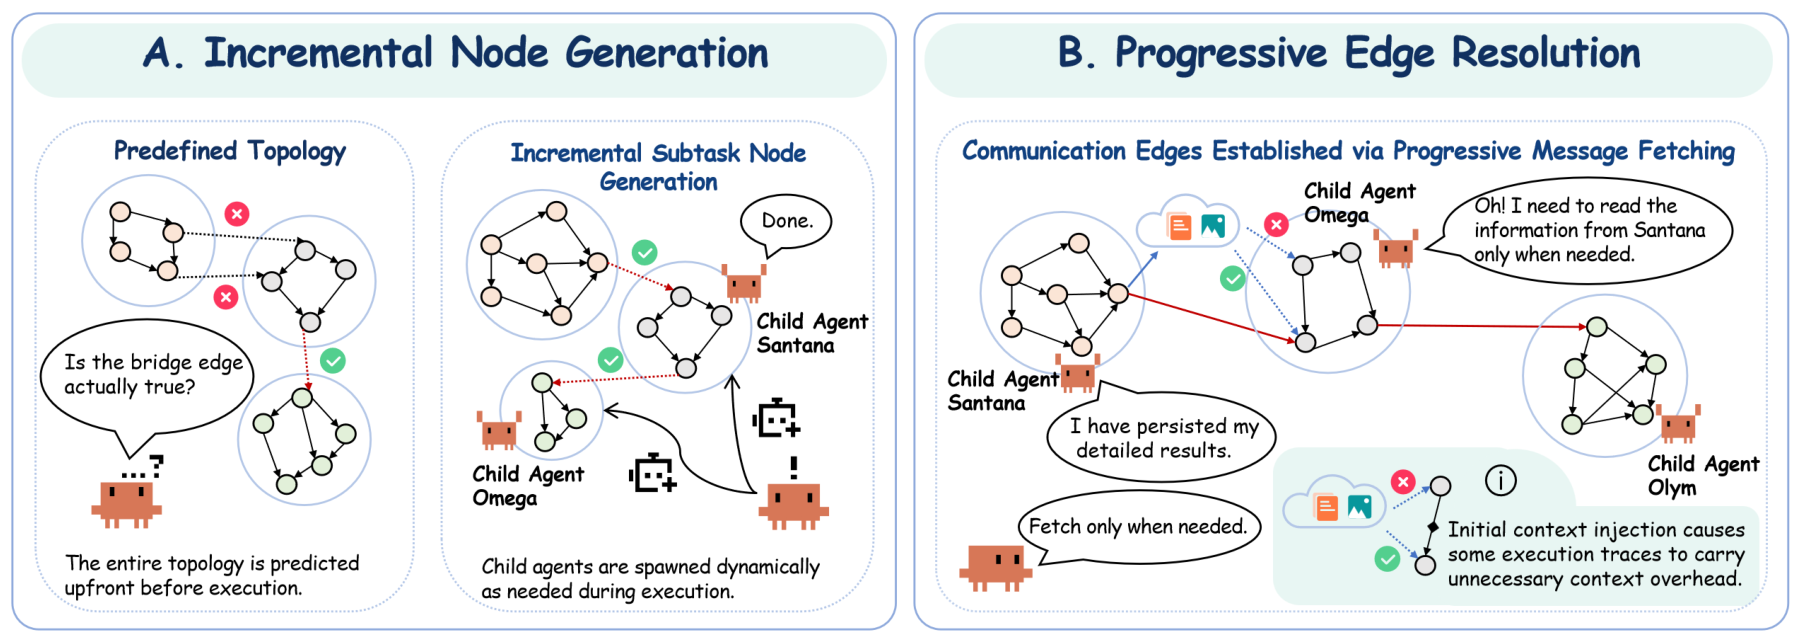
출처: Yuan et al., Rethinking Multi-Agent Collaboration: When More Is Less, Figure 2, 원문 PDF 5쪽. CC BY 4.0. 원문 그림 영역만 발췌·크기 조정했습니다.
왼쪽 A는 필요한 하위 작업이 드러날 때 노드를 추가하는 부분이고, 오른쪽 B는 필요한 메시지를 찾아 연결하는 부분입니다. 처음부터 모든 에이전트를 서로 연결한 조직도를 확정하는 방식과 다르죠. 다만 이것은 방법의 개요도이지 성능 비교 그래프가 아닙니다. 실제 이득은 본문의 실험 조건과 함께 읽어야 합니다.
저는 이 방향이 흥미롭습니다. 시작할 때 연구원 열 명을 무조건 만들기보다, 일을 하다가 실제로 독립적인 하위 문제가 발견되면 그 부분을 분리하는 거예요. 반대로 계속 같은 문맥이 필요한 작업은 한 에이전트가 유지하도록 하고요.
하지만 동적으로 팀을 만든다고 관리 비용이 사라지는 것은 아닙니다. 하위 작업을 잘못 나누면 나중에 결과를 합치기 더 어려워질 수 있습니다. 생성할지 말지 판단하는 비용도 들고, 역할과 종료 조건을 누가 관리할지도 필요합니다.
그래서 최근 논문을 읽을 때는 조직도가 얼마나 복잡한지보다 분해 판단을 어떻게 검증했는지가 궁금해집니다. 나누지 않았을 때보다 무엇이 좋아졌는지, 새로운 작업에서도 같은 기준이 통하는지요. 멋진 다이어그램은 결과를 이해하는 데 도움이 되지만 실험을 대신하지는 않습니다.
9. 실제 서비스 사례의 숫자는 어떻게 읽어야 할까?
Anthropic은 2025년 Research 시스템 소개에서 Opus 4를 상위 에이전트로, Sonnet 4를 하위 에이전트로 사용한 구성이 단일 Opus 4보다 내부 평가에서 90.2% 더 나았다고 보고했습니다. 동시에 자사 데이터에서 멀티에이전트가 일반 채팅보다 약 15배의 토큰을 사용한다고 설명했습니다. Anthropic Research 개발기
두 숫자는 비교 대상을 잘 봐야 합니다. 90.2%는 공개된 모든 업무의 성공률이 아니고, 15배의 기준은 단일 에이전트가 아니라 일반 채팅입니다. 이 둘을 나눠 “성능 대비 비용이 몇 배”라고 계산할 수는 없습니다.
또 실제 제품 사례는 실험실 벤치마크와 가치가 다릅니다. 서비스에서 운영된다는 점은 의미 있지만, 내부 평가의 조건을 외부에서 전부 재현하기는 어렵습니다. 반대로 공개 벤치마크 점수가 높다고 실사용 안정성이 보장되는 것도 아닙니다.
결국 자료마다 답하는 질문이 다릅니다. 논문은 비교 조건을 살펴보고, 제품 개발기는 어떤 문제를 해결했는지 읽고, 내 업무에 적용할지는 작은 실험으로 확인해야 합니다. 셋 중 하나를 다른 둘의 대체물로 쓰지 않는 것이 좋겠습니다.
10. 제가 실험한다면 비교군은 이렇게 두겠습니다
여기부터는 문헌 결과가 아니라, 그 결과를 바탕으로 제안하는 실험 설계입니다. 예를 들어 산업 동향 보고서 작성 과제를 40개 준비했다고 가정해볼게요. 실제로 이 실험을 수행했다는 뜻은 아닙니다.
첫 번째 비교군은 잘 구성한 단일 에이전트입니다. 필요한 검색 도구, 충분한 설명, 수정 기회를 제공합니다. 일부러 약한 단일 에이전트를 만들어놓고 멀티에이전트가 이겼다고 하면 의미가 줄어들겠죠.
두 번째는 같은 예산 안에서 여러 답을 독립 생성하고 선택하는 방식입니다. 복잡한 대화 없이 얻을 수 있는 이득을 확인하는 기준입니다. 세 번째는 역할을 분리한 멀티에이전트로 두고, 가능하다면 같은 시스템에서 통신만 제거한 비교도 해볼 수 있습니다.
예산은 한 가지만 맞추지 않는 편이 좋습니다. 전체 토큰을 맞춘 실험과 실제 결제 비용을 맞춘 실험은 의미가 다릅니다. 모델마다 가격이 다르고 입력과 출력 비용도 다르니까요. 실제 운영을 고민한다면 비용 기준을 우선 보고, 토큰과 대기시간도 함께 기록하겠습니다.
평가에는 글의 유창함만 넣지 않습니다. 사실 오류, 출처의 적합성, 누락된 핵심 항목, 계산 오류, 사람이 고치는 데 걸린 시간도 봐야 합니다. 보고서가 길어져서 점수가 높아지는 착시를 막으려면 분량 조건도 정해야겠죠.
그리고 최종 결과를 평가하는 사람에게 어떤 방식이 만든 글인지 가능하면 숨깁니다. “다섯 전문가가 토론한 결과”라는 설명만으로 더 믿음직해 보일 수 있으니까요. 평가 모델을 쓰더라도 순서 효과와 자기 계열 모델 선호 같은 가능성을 점검할 필요가 있습니다.
실패한 실행을 분모에서 빼지 않기
API 오류가 났거나 시간 제한에 걸렸다는 이유로 결과를 전부 제외하면 실제 운영 성능보다 좋아 보일 수 있습니다. 어떤 실패를 포함하고 어떤 경우에 재시도할지 미리 정하고, 시도한 수와 정상 완료한 수를 같이 적는 편이 낫습니다.
여러 번 생성한 답 중 하나라도 정답이면 성공으로 세는 pass@k와, 시스템이 실제로 고른 최종 답이 맞는 비율도 구분해야 합니다. 정답이 후보에 섞여 있다는 것은 좋지만 사용자가 그 정답을 받았다는 뜻은 아니니까요.
설정을 고르는 데 사용한 문제와 최종 확인용 문제도 나눠야 합니다. 같은 40개 문제를 계속 보며 프롬프트와 팀 구성을 바꾸면 그 문제에 맞춰지는 효과가 생깁니다. 새 과제에서도 좋아야 일반화라고 말할 여지가 생기겠죠.
11. 논문을 읽을 때 적어두면 좋은 질문
- 에이전트라고 부르는 단위가 독립적인 응답 샘플인가, 도구를 쓰며 상태를 유지하는 실행 주체인가?
- 수를 늘리면서 모델, 전체 계산량, 도구, 평가 방식도 같이 바뀌지는 않았는가?
- 단일 에이전트에도 비슷한 예산과 수정 기회를 줬는가?
- 좋아진 수치는 절대 점수 차이인가, 상대 개선율인가, 평가자의 선호 비율인가?
- 결과를 합치는 모델과 검증 비용까지 전체 비용에 포함했는가?
- 반복 실험의 변동과 실패한 실행 수를 공개했는가?
- 정적인 질문 답변에서 얻은 결과를 실제 환경의 장기 작업으로 확대 해석하지 않았는가?
- 테스트한 팀 규모 밖으로 주장을 늘리고 있지는 않은가?
이 질문을 적다 보면 멀티에이전트에 너무 까다로운 것 아닌가 싶기도 합니다.. ㅎㅎ 하지만 새로운 방식의 장점을 제대로 보려면 기준이 있어야 합니다. 조건이 불분명하면 정말 좋은 아이디어도 어디에 써야 할지 알 수 없으니까요.
12. 앞으로 흥미롭게 볼 연구 방향
제 관심은 고정된 인원수보다 언제 추가 에이전트를 부를지 판단하는 방식에 있습니다. 혼자 막혔을 때 다른 모델의 추론이 필요한지, 다른 자료가 필요한지, 아니면 그냥 도구 오류를 고치면 되는지 구분하는 문제예요.
또 하나는 검증에 자원을 얼마나 배분할지입니다. 후보를 열 개 만드는 것보다 후보 두 개를 만들고 검증을 더 하는 편이 나을 수도 있습니다. 반대로 검증기가 약하면 좋은 후보를 버릴 수도 있고요. 생성과 선택을 한 묶음으로 최적화해야 할 것 같습니다.
큰 팀에서는 공유 상태를 어떻게 유지할지도 궁금합니다. 결과를 한곳에 저장하더라도 누가 마지막으로 수정했는지, 어떤 근거로 바뀌었는지, 서로 충돌하는 결과는 어떻게 처리하는지가 남습니다. 에이전트가 많은 시스템은 언어모델 연구이면서 분산 시스템 설계 문제이기도 하다는 생각이 듭니다.
마지막으로, 연구나 산업 현장에서는 결과가 좋다는 기준을 더 바깥에 둘 필요가 있습니다. AI끼리 합의한 과학적 설명과 실제 계산·실험에서 확인된 결과는 다릅니다. 수치 계산이 필요한 문제는 계산으로, 실험이 필요한 주장은 실험으로 이어져야 합니다. 에이전트 수가 늘어도 그 확인 절차를 건너뛸 수는 없습니다.
마무리: “몇 명인가” 다음의 질문
문헌을 따라가 보면 모두가 한 방향으로 “많을수록 좋다”고 말하고 있지는 않습니다. 독립적인 후보 생성, 토론과 집계, 통신 절약, 실패 분석, 다양성과 작업 의존성이라는 서로 다른 질문이 쌓이고 있습니다.
저는 이 분야가 재미있는 이유도 여기에 있다고 생각합니다. 단순히 모델을 복제하는 것만으로 끝나지 않고, 어떤 정보를 나눠 갖게 할지와 무엇을 믿을지까지 설계해야 하거든요. 실제로 일을 맡기는 문제에 가까워질수록 연구해야 할 부분이 더 구체적으로 보입니다.
그래서 당장 프로젝트에 적용한다면 “에이전트 열 명을 만들어보자”보다 이렇게 시작하고 싶습니다. 한 명이 어디서 실패하는지 보고, 그 실패를 줄일 수 있는 독립적인 역할 하나를 추가해보자. 그리고 같은 돈과 시간으로 정말 나아졌는지 확인하는 거예요.
숫자를 늘리는 것은 쉽지만, 늘릴 이유를 설명하는 것은 조금 어렵습니다. 앞으로 Agent Scaling 논문을 볼 때는 그 이유가 실험으로 뒷받침되는지 계속 살펴보려고 합니다. 지금까지 삶은 AI였습니다. 감사합니다!
원문과 판본
- Self-Consistency Improves Chain of Thought Reasoning in Language Models, 2022년 최초 공개, ICLR 2023 판본.
- Improving Factuality and Reasoning in Language Models through Multiagent Debate, 2023년 최초 공개.
- More Agents Is All You Need, 2024년 v2, arXiv에 TMLR 출판 명시.
- Mixture-of-Agents Enhances Large Language Model Capabilities, 2024년 최초 공개 판본.
- Cut the Crap: An Economical Communication Pipeline for LLM-based Multi-Agent Systems, AgentPrune, 2024년 원고.
- Why Do Multi-Agent LLM Systems Fail?, 2025-10-26 v3.
- Towards a Science of Scaling Agent Systems, 2026-04-08 v3. 초기 소개 글과 실험 수가 다릅니다.
- Understanding Agent Scaling in LLM-Based Multi-Agent Systems via Diversity, 2026-02-03 프리프린트.
- Rethinking Multi-Agent Collaboration: When More Is Less, 2026-09-18 v2 프리프린트.
- Anthropic, How we built our multi-agent research system, 2025-06-13. 논문 벤치마크와 구분해 읽을 제품 개발 사례.
자료 확인: 2026년 10월 23일. 본문의 투표 확률과 보고서 평가 계획은 설명을 위한 가정이며, 직접 수행한 에이전트 성능 실험이 아닙니다.
댓글/요청
문의나 포스팅 요청은 상단 Contact 메뉴로 연락해주세요.